Inference Serving 全景:从指标、瓶颈到框架与生态
October 31, 2026
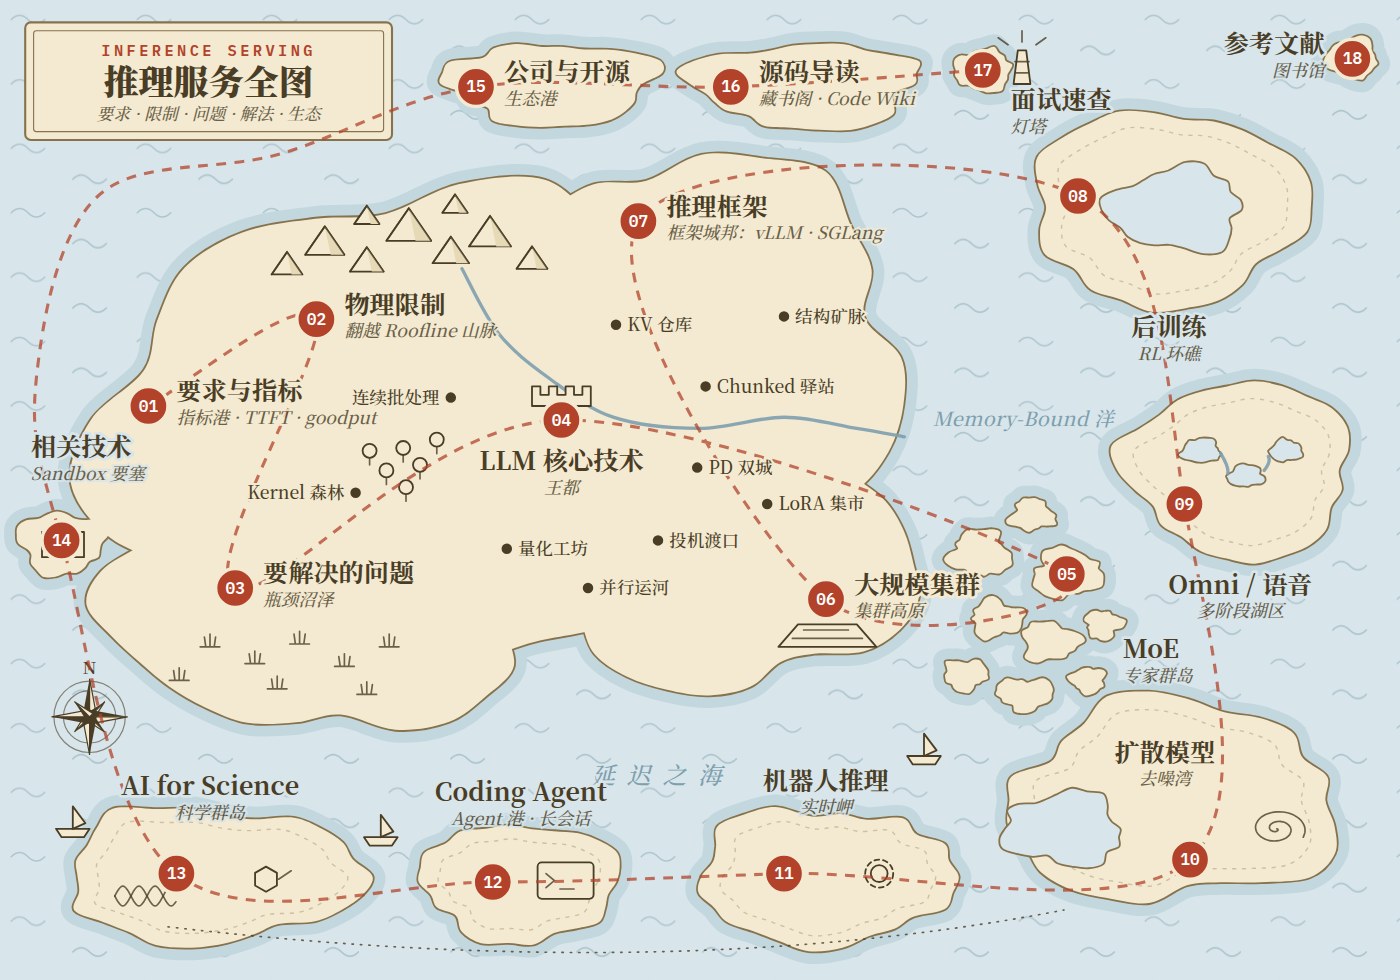
为了准备 inference serving 方向的面试,我把这个领域系统整理成了一张“地图”。仿照《Designing Data-Intensive Applications》每章开头的地图,整份笔记被画成一片大陆和群岛:西岸的指标港是起点,翻过 Roofline 山脉、穿过瓶颈沼泽,到达 LLM 核心技术的王都;海上的岛屿则是换了负载之后的世界。
打开交互式全景图 → · 下载 PDF(75 页) · GitHub 源码
这份笔记讲什么
整份笔记按“要求 → 限制 → 问题 → 解法”展开:
- 要求与限制:TTFT、TPOT、goodput 等指标,roofline、KV cache 显存、互联带宽这些物理约束。
- LLM serving 核心技术:continuous batching、PagedAttention、前缀缓存、chunked prefill、PD 分离、投机解码、kernel、量化、并行策略。每项技术都对应到它解决的具体问题。
- 扩展到 MoE 和大规模集群:宽 EP、DeepEP、EPLB,KV 感知路由,自动扩缩容。
- 推理框架:vLLM、SGLang、TensorRT-LLM 的架构与对比。
- 换了负载之后:后训练(RL rollout)、Omni / 语音、扩散模型、机器人、Coding Agent、AI for Science。每个领域都拆解成“模型特征 → 场景 → 推理负载”这条因果链。
- 周边与生态:sandbox(包括 OpenSandbox)、网关与观测、公司与开源项目地图。
- 源码导读与面试速查:约 180 个固定到具体 commit 的源码链接,附 Google Code Wiki 链接;另有估算公式和高频面试问题。
怎么读
交互版默认只显示全景地图,点击任意地点,章节会在右侧打开,地图保持在左侧作为导航;支持深色模式和手机。PDF 版带封面和可点击的目录,每章以地图上对应位置的局部截面开头。
内容整理自公开的论文、官方文档与开源代码,观点仅代表个人;生态信息截至约 2026 年中,变化很快,欢迎指正。
相关
想动手实现一个多阶段 omni 推理服务的核心部件,可以看我的另一套练习:nano-vllm-omni 自学手册:26 道一小时练习吃透 vLLM-Omni。